인공지능 입문: 탐색에서 학습까지
발표 모드 / Present인공지능 입문
탐색에서 학습까지 — 문제를 표현하고 해법을 평가하는 방법
- 상태와 행동으로 작은 문제를 모델링합니다.
- 너비 우선 탐색을 코드로 구현합니다.
- 탐색과 지도학습의 차이, 평가 데이터의 역할을 설명합니다.
문제를 먼저 정의하기
| 구성 요소 | 길찾기 예시 |
|---|---|
| 상태 | 현재 위치 |
| 행동 | 연결된 장소로 이동 |
| 목표 검사 | 목적지에 도착했는가? |
| 비용 | 이동 횟수 또는 거리 |
같은 지도라도 최소 이동 횟수와 최소 거리는 서로 다른 목적입니다.
상태 공간을 그래프로 보기
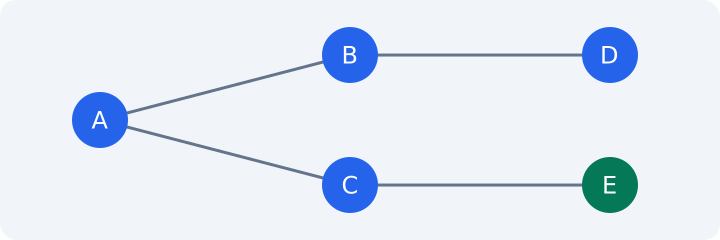
시작점은 A, 목표는 E입니다. 모든 간선의 비용이 같다면 최소 간선 수 경로를 찾을 수 있습니다.
너비 우선 탐색의 원리
- 시작 노드를 큐에 넣고 방문했다고 표시합니다.
- 큐의 앞에서 노드를 하나 꺼냅니다.
- 목표라면 경로를 반환합니다.
- 아직 방문하지 않은 이웃을 큐의 뒤에 추가합니다.
방문 표시는 큐에 추가할 때 합니다. 순환 그래프에서도 같은 노드를 반복해서 넣지 않습니다.
Python으로 경로 찾기
from collections import deque


def shortest_path(graph, start, goal):
    queue = deque([start])
    parent = {start: None}
    while queue:
        node = queue.popleft()
        if node == goal:
            path = []
            while node is not None:
                path.append(node)
                node = parent[node]
            return path[::-1]
        for neighbor in graph.get(node, []):
            if neighbor not in parent:
                parent[neighbor] = node
                queue.append(neighbor)
    return None
deque의 앞쪽 제거와 뒤쪽 추가를 사용합니다. Python 문서
실행하고 조건을 바꿔 보기
graph = {"A": ["B", "C"], "B": ["D"], "C": ["E"]}
assert shortest_path(graph, "A", "E") == ["A", "C", "E"]
assert shortest_path(graph, "A", "A") == ["A"]
assert shortest_path(graph, "D", "E") is None
- B에서 A로 돌아가는 간선을 추가해도 종료할까요?
- 모든 간선의 비용이 다르면 최소 비용 경로가 보장될까요?
- 이웃의 순서가 바뀌면 같은 길이의 경로 중 선택 결과가 달라질까요?
탐색과 지도학습 비교
| 관점 | 탐색 | 지도학습 |
|---|---|---|
| 주어진 정보 | 상태·행동·목표 | 입력과 정답의 예시 |
| 구하는 것 | 목표까지의 경로 | 새 입력을 예측하는 함수 |
| 예시 | 지도에서 경로 찾기 | 이메일의 스팸 여부 분류 |
| 확인할 것 | 해의 정확성·비용 | 보지 못한 데이터의 성능 |
하나의 AI 시스템에서도 탐색과 학습을 함께 사용할 수 있습니다.
학습 목표를 수식으로 표현하기
회귀 문제에서 예측값 와 실제값 의 차이를 측정하는 한 가지 방법은 평균제곱오차입니다.
실제값이 [2, 4], 예측값이 [1, 5]이면 MSE는 1입니다.
작은 학습 오차만으로 새 데이터에서의 성능을 보장할 수는 없습니다.
평가 데이터를 분리하기
- 학습 데이터로 모델을 학습합니다.
- 검증 데이터 또는 교차검증으로 모델 설정을 비교합니다.
- 최종 테스트 데이터는 마지막 평가를 위해 남겨 둡니다.
- 전처리도 학습 데이터에서 학습하고, 검증·테스트 데이터에 적용합니다.
데이터의 시간 순서나 동일 대상의 반복 관측을 무시하면 평가 결과가 과도하게 좋아질 수 있습니다.
확인 문제와 참고 자료
- BFS에서 큐 대신 스택을 사용하면 탐색 순서는 어떻게 달라질까요?
- 방문 표시를 하지 않는 경우 어떤 그래프에서 문제가 생길까요?
- 테스트 점수를 보면서 모델을 계속 고르면 평가의 의미가 어떻게 달라질까요?
참고 자료